将 GEO 拆为获取、检索、引用、表述和行动五层,分别判断网页可访问、资料相关、引用有据、品牌描述准确与用户行动。五层是排查框架,每个结论都需要对应证据。
品牌出现在 AI 答案里,却没有得到推荐。文章被引用了,却没有带来产品咨询。官网没有出现在来源列表中,第三方文章倒把品牌带进了答案。
如果把这些情况都归成“做上去了”或“没做上去”,下一步就容易失去方向。
该修网站、补产品资料,还是调整问题范围?单看品牌名有没有出现,回答不了。
我把这个问题拆成五层,分别观察信息怎样进入回答,以及回答之后发生了什么。
| 层次 | 要回答的问题 |
|---|---|
| 获取层 | 信息能不能读到? |
| 检索层 | 能不能找到与问题相关的资料? |
| 引用层 | 哪些资料被列作回答依据? |
| 表述层 | 品牌被怎样描述和比较? |
| 行动层 | 用户是否访问、咨询或购买? |
先说明这张图怎么用
五层是诊断框架,不是各平台统一的内部流程。真实系统可能反复检索、交叉生成,品牌也可能通过第三方进入答案。
本文讨论带有外部检索的回答。观察只支持对应层次的判断:引用不等于推荐,推荐不等于成交,指标变化也不能直接归因于优化。
下文的软件 A 是虚构教学示例。Google、Bing 的机制各有适用范围;看不到的过程保留为未知,不靠最终答案反推内部原因。
网页仍然重要,排名却解释不了整个答案
传统搜索本来就包含多个环节。Google 将其概括为抓取、索引和提供搜索结果;一个页面不一定能走完所有阶段。〔1〕
生成式搜索又增加了一个值得单独观察的结果:系统如何利用找到的信息组织回答。
Google 对 AI Overviews 和 AI Mode 的说明提到,它们可能把用户问题展开为多个相关查询,寻找不同子主题的资料。〔2〕
据此,一次普通搜索中看到的网页顺序,无法完整解释最终答案采用了哪些材料。
还要分清“模型知道”和“系统查到”。检索增强生成的早期研究,将模型参数中的知识与外部检索材料结合起来。〔3〕
因此,回答能使用新资料,并不要求先把资料写进模型参数。今天的回答出现了新产品信息,也不能仅凭这一点就说“模型已经学会了我们”。
判断来源,仍要回到可见的搜索过程、引用与原始页面。
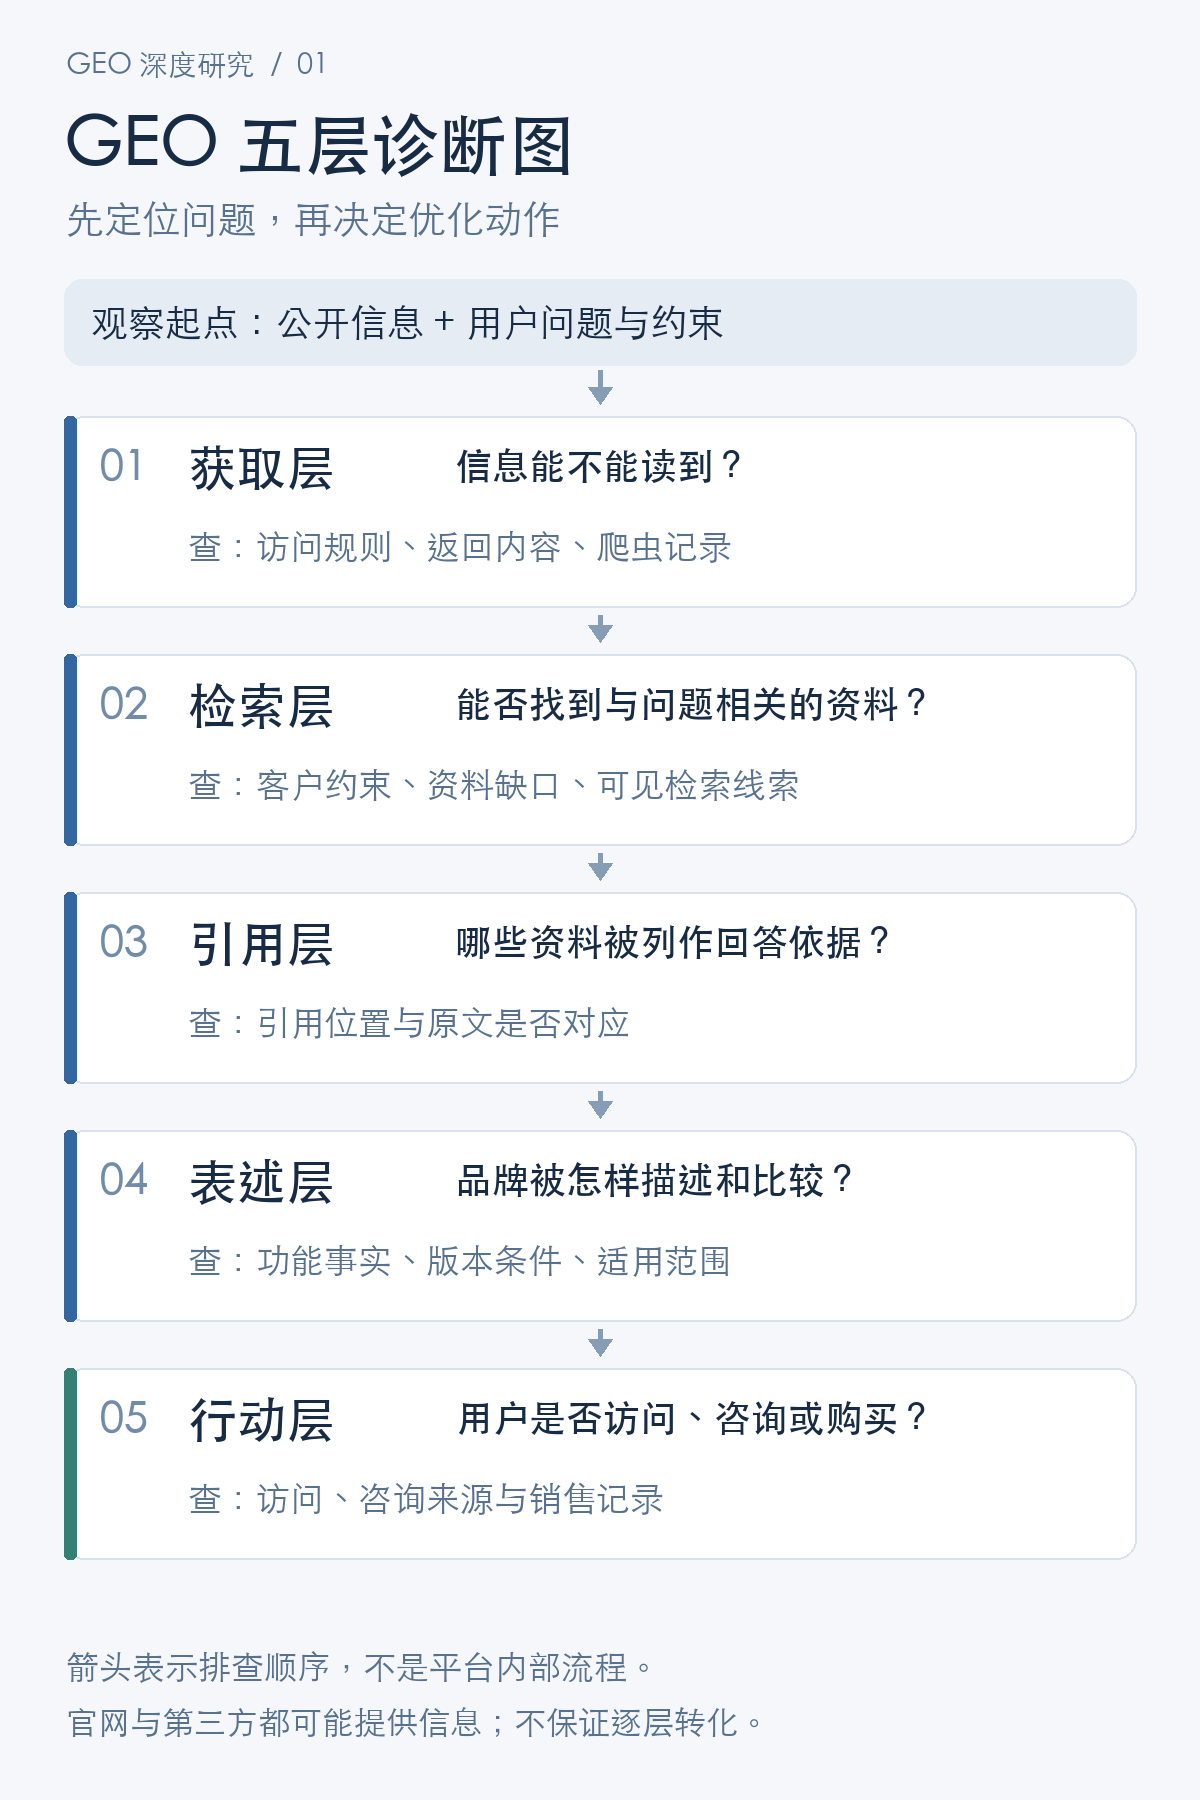
图中箭头表示排查顺序。品牌无需先获得官网引用,才有机会被推荐。
获取层:先确认信息能不能读到
假设排班软件 A 支持连锁门店管理,产品说明却只有登录后才能看到。
此时先研究什么标题更容易被引用,就跳过了基础问题:外部系统能不能读到这份资料?
要检查的对象很具体:页面是否公开,服务是否正常,访问规则是否允许读取,关键内容是否真正出现在返回的页面中。
浏览器里看得见,只说明人工访问成功。目标爬虫取得了什么,还需要结合平台检查工具和经验证的访问记录判断。
对 Google 生成式搜索,官方指南列出的资格包括索引、摘要展示资格,以及 Search Console 中相关生成式功能的纳入设置。满足条件仍不保证展示。〔4〕
这一层的成果应该写得具体:访问限制已修复,或者目标爬虫已取得相关页面。
检索层:资料能否回答客户的具体问题
继续看软件 A。官网可以访问,页面上写着“智能协同,赋能管理”。客户问的却是:
我们有十家门店,员工经常跨店支援,什么排班软件能处理?
“找到这家公司”和“找到跨店排班资料”,是两种检索任务。
如果产品确实支持,公开资料就应说明员工归属、班次冲突和配置条件。只有笼统介绍,即使找到官网,也可能不足以回答问题。
这并不要求把每种问法都写成一篇文章。Google 的指南说明,其系统能够理解同义表达和含义,不要求逐一覆盖所有长尾措辞。〔4〕
值得做的是把客户约束与已有资料对照,找出真正缺失的事实。
这一层也最容易被误判。运营人员通常看不到完整的内部候选集,搜索过程或来源面板只提供部分线索。
没有出现在最终引用里,不能直接证明它从未被检索过。 普通搜索中能找到文章,也不能证明某次 AI 回答调用了它。
引用层:被引用的页面,支持了哪句话
假设 A 的团队写了一篇排班指南,AI 在解释“如何减少班次冲突”时引用了它。
这次引用可能支持一条行业方法,也可能支持某项产品事实。要知道是哪一种,需要把引用附近的论述与原文对起来。
如果文章贡献了通用建议,答案推荐的却是其他产品,“内容被采用”和“产品进入候选”就分开了。
Bing 对 AI Performance 的说明也很明确:页面引用次数反映被引用的频次,不表示页面的重要性、排名或在答案中的位置。〔5〕
检查这一层,从一个动作开始就够了:找出引用对应的句子,打开原文,核对它是否支持这句话。
例如,原文写的是“企业版可配置跨店权限”,回答却省略了版本限制。引用存在,表述仍可能失真。
内容侧可以把功能、版本、限制和证据放在容易理解的位置。这提高了核验的便利程度;能否增加引用,留给后续观察。
表述层:品牌以什么身份出现
品牌名出现以后,还要读完那句话。
“A 支持跨店排班”“A 的企业版支持跨店排班”“需要完全离线时,A 可能不适合”,含义显然不同。
至少要分清:事实是否准确,条件是否完整,以及在给定条件下有没有进入候选。
假设 A 确实不支持离线排班,客户又明确要求完全离线。事实得到纠正后,A 可能退出推荐名单。
推荐次数下降,也可能是一次正确纠错的结果。 反过来,把不存在的能力说成卖点,即使看起来推荐得很好,也会制造错误预期。
这一层的目标,是让品牌事实、适用范围和比较依据得到准确表达。
发现错误时,先看可见来源:当前产品页、旧新闻,还是第三方介绍?能定位到过时信息,就针对它处理;没有线索,暂时不确定原因。
行动层:回答之后,用户做了什么
假设 A 进入了合适的名单,功能描述也准确。接下来要查看访问记录、咨询来源和销售跟进情况。
用户可能继续追问、访问别处、过几天再搜索品牌,也可能就此结束。回答截图里看不到这些行为。
客户说“AI 推荐我来的”,是有价值的线索,但不是成交只有一个原因的证明。
如果答案改善了,咨询没有变化,可以分别检查问题是否有购买意图、实际触达是否有限、页面能否承接需求,以及产品是否满足客户约束。
这一层把 GEO 接回业务,也让团队看清哪些问题需要产品、内容和销售共同解决。
用同一个问题,完整走查一次
下面仍是软件 A 的虚构教学情境,不代表实际测试结果。
团队想知道,为什么 A 没进入“十家门店、跨店支援”的推荐名单。先固定问题,保存平台、联网条件、时间和完整回答。
获取层:检查工具显示产品页可访问,暂时排除该页面的访问障碍。
检索层:逐项对照客户要求,发现公开资料没有说明跨店排班。内部是否检索过官网仍未知,但资料缺口已经明确。
引用层:打开回答的来源,发现引用 A 的文章只在介绍通用排班方法。
表述层:原文写“企业版支持”,回答却省略了版本条件。团队补齐公开说明,再按相同条件复测,记录表述是否改变。
行动层:即使后续进入名单,也继续查访问与咨询记录,不能把推荐截图当作获客结果。
这次走查确定了两个可执行动作:补充跨店场景资料、明确版本条件。改完后分别复测,不预设必然有效。
下一步,先确定你要验证什么
一次走查不必填满所有格子。能确认的写清楚,缺少证据的保留为未知。
针对每个动作,先写两句话:准备解决哪个障碍?用什么证据判断它是否缓解?
修复页面访问,就检查访问结果。补充功能限制,就观察后续回答是否准确表达。调整咨询入口,就看访问与咨询行为。
这比把所有工作汇总成一个“可见性总分”,更容易决定下一步。
再次看到“品牌没有出现在答案里”,先保留观察,再问:目前的证据,能把问题定位到哪一层?
资料来源
〔1〕Google Search Central,In-depth guide to how Google Search works。用于说明抓取、索引与提供搜索结果。
〔2〕Google Search Central,AI features and your website。用于说明查询展开(query fan-out)。
〔3〕Lewis 等,Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,2020,arXiv:2005.11401。用于技术背景,不代表所有商业平台的实现。
〔4〕Google Search Central,Optimizing your website for generative AI features on Google Search。用于展示资格与内容表达说明。
〔5〕Microsoft Bing,Introducing AI Performance in Bing Webmaster Tools Public Preview,2026-02-10。用于引用指标的定义。
资料查阅于 2026 年 10 月 6 日。可按机构与原文标题检索。
GEO 深度研究:机制、证据与边界 · 第 01 篇