品牌提及率不等于客户触达率。同一批记录可因汇总方式得到不同结果;题库覆盖、采集条件、计分规则和不确定性,决定一份 GEO 报表能够证明什么。
一份 GEO 报告写着“品牌提及率 50%”。这意味着,每两个潜在客户向 AI 提问,就有一个会看到你吗?
先别急着把百分号翻译成客户。
它可能只表示:团队挑了几道题,在某个平台、某种设置下问过几轮,按一套规则汇总后,得到了 50%。
这个结果可以有用。但从测试题到真实客户,中间还有一段没有被测量的距离。
GEO 测量首先要回答的,是这个数字究竟在描述谁、描述什么。 至于改善是否由优化造成,是另一道因果问题,本系列 GDR-03专门讨论。
下文以虚构的排班软件 A 演示,所有次数和比例均为教学算例。题库划分、计分及记录方式是本文的实操建议,不是平台统一标准,也不是已经验证过的效果方案。
出现了名字,不等于进入候选名单
假设我们想知道:不知道 A 的门店管理者,在询问排班方案时,有没有机会看到它。
于是问:“多家门店临时调人,排班软件怎么选?”
AI 回答“可以考虑 A”,和回答“A 不支持你的条件”,都出现了品牌名。按字符串计数,两条都命中;按选型意图,含义几乎相反。
如果问题本身是“A 支持跨店排班吗”,回答再重复 A,也不能算一次非品牌需求下的自然发现。
所以,先确定要观察的行为,再决定怎么计分。几种常见记录可以分开:
| 记录项 | 本文建议的判断口径 |
|---|---|
| 正文提及 | 回答正文明确出现可识别的品牌实体 |
| 候选推荐 | 回答把品牌列为满足该需求的可考虑方案 |
| 官网引用 | 回答的可见引用链接指向该品牌官网 |
| 事实错误 | 回答中的具体产品说法与核验资料冲突 |
这些记录可以同时成立。一条回答可能推荐了 A,却说错了适用版本;也可能引用官网,只为了说明它不适合。
品牌别名如何匹配、同名公司如何排除、只有引用标题出现名字算不算,都要提前写清。否则,同一批回答交给两个人,可能得到两张报表。
平台提供的指标也有自己的范围。Bing 在 2026 年 2 月的 AI Performance 发布说明中明确:页面引用次数反映被引用的频次,不表示页面的重要性、排名或位置。〔1〕
拿到一个官方数字,仍然要读它的定义。网页引用、品牌推荐和客户看见了什么,不能仅靠换个列名就连在一起。
同一批记录,为什么既能算出 17.3%,又能算出 50%
现在只观察“候选推荐”。为了看清分母的作用,先把题库缩成两道题,并假设所有采集都完整可判定。
| 非品牌需求问题 | 推荐 A/有效回答 |
|---|---|
| 多门店临时支援,怎么选排班软件? | 9/10 |
| 小店预算有限,有哪些排班工具? | 10/100 |
如果把所有回答放在一起,推荐比例是:
(9+10)÷(10+100)≈17.3%。
如果先算每道题的推荐比例,再给两道题相同权重,结果是:
(90%+10%)÷2=50%。
两个计算都没有错。17.3% 描述这 110 条回答里有多少条推荐了 A;50% 描述两道题等权时的平均推荐表现。
前者让问了 100 次的题占据更大权重。这个权重来自采集次数,未必来自真实客户需求。
后者让每道题同等重要。但“同等重要”也是一种选择,不能因为算得整齐,就把它当作市场的真实结构。
如果报告只写“推荐率”,读者根本不知道自己看到的是哪一个。
再换一个口径:两道题都至少有一次推荐 A,因此“至少命中过一次的问题占比”是 100%。这个数字能够帮助寻找出现过的场景,却不能说明 A 经常被推荐。问得越多,曾经命中过的机会也可能越多。
汇总方式决定了你在回答哪个问题。计算之前,就该选定它。
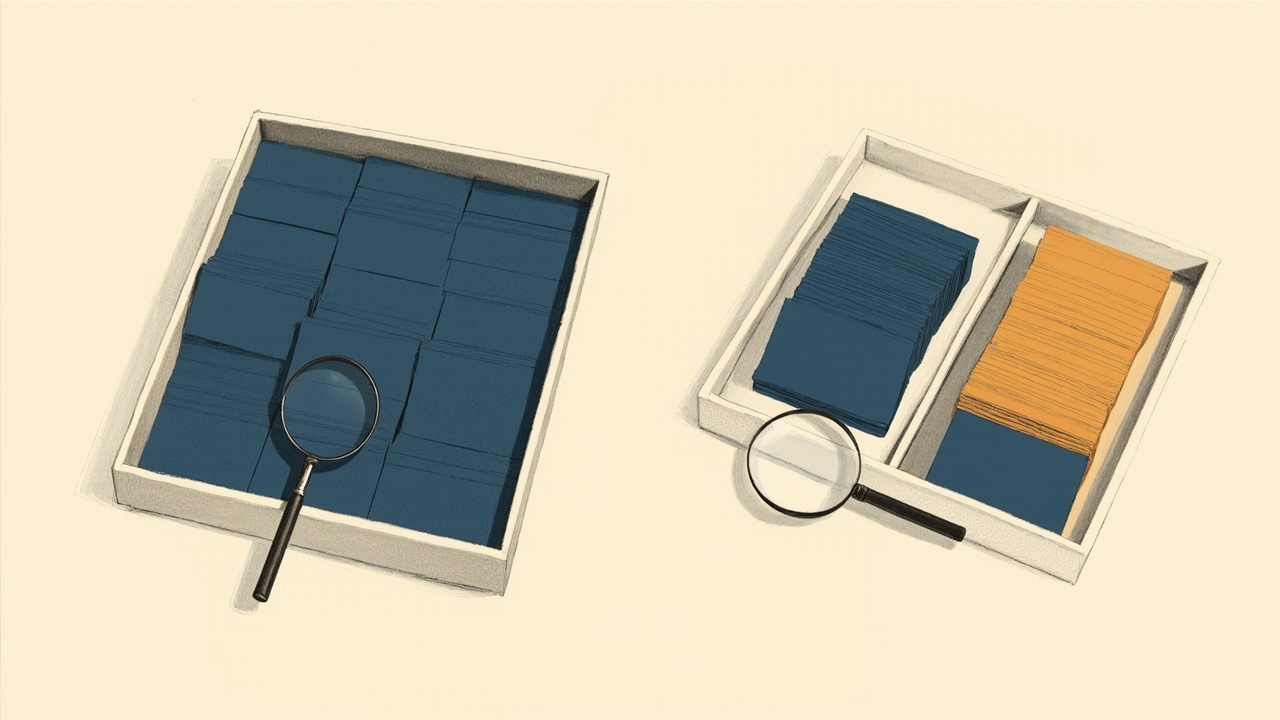
不同的分组与汇总方式,回答的是不同问题。概念插画,不对应具体数量。
题库测得很稳,也可能离客户很远
把这两道题各问一千次,可以继续观察它们的回答波动。但即使结果逐渐稳定,也不能告诉我们:真正的客户有多少在意跨店支援,有多少在意价格,又有多少首先关心数据迁移。
重复提问增加的是对已有题目的观察,没有自动补上漏掉的需求。
题库的来源因此比数量更值得解释。
客服记录能提供客户原话,却可能更偏向已有用户。销售访谈接近购买过程,却容易漏掉没有进入销售渠道的人。站内搜索反映到访者的需求,也不等于整个市场。
这些材料各有用途。需要保留的是它们来自谁、覆盖什么,以及看不见哪些人。
用 AI 扩写问题也一样:它能生成更多表达,不能凭空证明每种表达有多少真实用户在问。同一道需求换十种说法,若直接当作十个等权问题,还可能把这个需求的分量放大。
本文建议先按需求归组,再保存原话及改写版本。报告分别展示各类需求的结果;需要总分时,交代各类权重及依据。
没有可靠的需求占比,就把它叫作“固定题库表现”。业务上优先关注高价值客户也可以,但那是业务优先级,不能冒充用户分布。
美国民意研究协会 AAPOR 的披露规范要求研究者说明研究对象、样本生成方式、问题原文和加权方法,并交代设计局限。这里借用的是调查与内容分析的透明性原则,不是把 AI 回答当作受访者,也不声称 GEO 有了统一抽样标准。〔2〕
这个原则落到 GEO 上很具体:题库从哪里来,决定了结果能够被解释到哪里。
照亮一部分需求,不代表看见了整个市场。概念插画。
一个精确的小数,可能藏着几种不确定
即使题库固定,采集条件变了,数字也未必能直接比较。
独立新会话与连续追问、联网与未联网、不同账号和地区,都应分开记录。API 测试要注明接口和模型标识;消费端测试要保存入口、可见版本和设置。两种入口不能只凭模型同名就混成一组。
能控制的条件保持一致,无法确认的就记为未知。开了新会话,也不能据此宣布所有个性化影响已经消失。
再看失败记录。
如果请求超时,根本没有取得回答,就不知道它会不会推荐 A。不能直接算作“未推荐”,也不能删掉之后假装没发生过。
可以报告可判定回答中的推荐比例,同时单列计划次数、实际采集次数、完整可判定数和失败原因。如果失败集中在某些题目或某个平台,剩下的结果就可能失去可比性。
模型完整回答“没有合适方案”,则是另一回事:在“是否推荐 A”的口径下,这通常是可判定的未推荐。拒答、截断及语义含糊的回答怎样处理,也要事先约定,不能看到结果后再决定去留。
回答收齐了,判定仍可能出错。可以抽取一部分回答,让两位评阅者独立判断,保留分歧及裁定依据;用模型辅助判定时,也要保存版本、规则和人工抽查结果。
AAPOR 对内容分析的披露要求包含编码规则与评阅一致性信息,这为记录“是谁、按什么规则判定的”提供了参考。〔2〕
至于统计区间,不能只把调用次数填进一个计算器。同一题的重复回答、相近问法和同一时段的记录可能相关;区间要与采样、加权及相关性处理相匹配。
即使算出了合理的区间,它也不会自动包含题库遗漏、错误标签和入口差异带来的问题。小数点后的精度,不能代替这些说明。
给每张报表附一份“口径说明”
不必把全部研究说明塞进周报。把下面这份说明填清楚,数字就更容易复核。
想回答的问题: 在__平台、__入口与__时间段,品牌在__类需求中的__表现如何?准备将结论用于__,不外推至__。
题库与权重: 问题集版本__;共__个需求组、__道题;来源__;品牌问题是否单列__;改写题如何归组__;权重及依据__。
判定与分母: 命中的具体标准__;别名和否定表达处理__;按回答汇总还是先按题汇总__;有效回答、拒答及无法判定的规则__。
采集条件: 账号、地区、语言、联网、上下文与可见版本__;每题计划次数和时段__;重试及保留规则__;无法控制的条件__。
结果与复核: 完整可判定数__;失败或缺失数及原因__;各需求组结果__;不同轮次的波动__;人工分歧或模型判定抽查__;原始回答与引用记录位置__。
这份模板是本文的操作建议。AAPOR 的完整规范覆盖更多内容,不能用填完这几行来声称获得认证或符合全部标准。〔2〕
回到软件 A,那张只有“50%”的报表,现在可以写成:
在本次指定入口与设置下,两道非品牌需求题的等权平均推荐比例为 50%。逐题结果为 9/10、10/100;两题均曾被推荐。所有回答完整可判定。题目由团队选择,缺少真实需求占比依据,因此不据此估计潜在客户看见品牌的比例。
它没有原来的大数字醒目,但读者终于知道了 50% 是什么。
固定题库的价值,在于持续观察
限定结论,并不会让题库失去价值。
一组规则明确、条件可追溯的问题,可以帮助团队发现:哪些需求总是遗漏品牌,哪些推荐理由持续出错,哪些问题的表现反复变化。这些都能引导下一步排查。
为了兼顾比较与探索,可以保留一组固定问题,另设新增需求区。新发现的问题先单独展示,调整正式题库时保留版本;不要换了题、换了权重,却把新旧总分无缝接成一条增长曲线。
测量做到这里,才有基础继续问:差异是否稳定,是否由优化造成,是否与业务结果有关。
下一次看到“提及率 50%”,先找到它旁边的那行说明:什么问题、什么条件、多少有效记录、按什么规则算出的 50%?
如果这一行还写不出来,报表就还没完成。
资料来源
〔1〕Microsoft Bing Blog,Introducing AI Performance in Bing Webmaster Tools Public Preview,2026-02-10。用于说明页面引用频次的指标边界;本文不据此推断其他平台的统计定义或最新功能清单。
〔2〕AAPOR,Disclosure Standards,页面所载规范版本为 2021 年 4 月。用于研究对象、样本、权重、判定方法和局限的披露原则,不是 GEO 平台效果研究。
资料查阅于 2026 年 10 月 8 日,可按机构与原文标题检索。本文未进行平台实测。
GEO 深度研究:机制、证据与边界 · GDR-02
封面与插画由 MiniMax AI 生成。